Infrastructure
SpaceXAI place le calcul de Grok hors de tout réseau
La nouvelle puce Vera de NVIDIA orchestre désormais l'IA de Grok pour SpaceXAI, et la même annonce révèle Starmind, le premier satellite IA conçu pour l'espace.
La nouvelle puce Vera de NVIDIA orchestre désormais l'IA de Grok pour SpaceXAI, et la même annonce révèle Starmind, le premier satellite IA conçu pour l'espace.
Le nouvel accord de 2 millions de GPU entre AWS et NVIDIA nomme une réserve de 100 000 GPU pour le gouvernement américain. Il ne nomme aucun engagement équivalent pour l'Europe.
La puce Jalapeno d'OpenAI a devancé le Blackwell de Nvidia en performance par watt dans de nouveaux tests, mais la directrice financière d'OpenAI dit qu'elle complète Nvidia sans le remplacer. Ce que cela signifie pour les acheteurs de calcul IA.
Cisco et Nvidia ont ajouté des systèmes Supermicro à l'échelle du rack à leur Secure AI Factory, en nommant les opérateurs de cloud souverain comme client cible, pas seulement les hyperscalers. Disponible en octobre 2026.
OpenAI a publié les premiers benchmarks de sa puce d'inférence Jalapeno, avec une meilleure efficacité énergétique que la GB300 de Nvidia. Les chiffres viennent uniquement d'OpenAI.
SK Hynix et Samsung ont présenté des solutions rivales à la limite de 775 microns de la mémoire HBM lors de Hot Chips 2026, et SK Hynix maintient le choix sûr pour toute la génération Rubin de Nvidia.
La puce d'inférence Groq 3 LPX de Nvidia est entrée en production complète le 24 août 2026, construite sur une technologie et des talents que Nvidia a pris à Groq lors d'un accord de licence de décembre 2025.
AMD a atteint 30,3 pour cent des livraisons de processeurs x86 client au deuxième trimestre 2026, selon Mercury Research, une première au-dessus de 30 pour cent dans tous les segments a la fois.
Starcloud a levé 250 millions de dollars pour une valorisation de 2,3 milliards, avec Nvidia comme nouvel investisseur, misant sur des centres de données orbitaux qui contournent le réseau électrique.
Le nouveau processeur 2 nm d'IBM exécute des instructions Arm et IBM Z sur le même cœur, la première puce issue du partenariat avec Arm annoncé en avril 2026, pensée pour la pénurie de compétences mainframe.
La feuille de route de SK hynix, publiée dans Nature Electronics, fixe des objectifs de plus de 100 Tb/s, moins de 1 pJ/bit et une latence sous 10 ns - et affirme que le prochain goulot d'étranglement de l'IA n'est pas la puce, mais l'interconnexion.
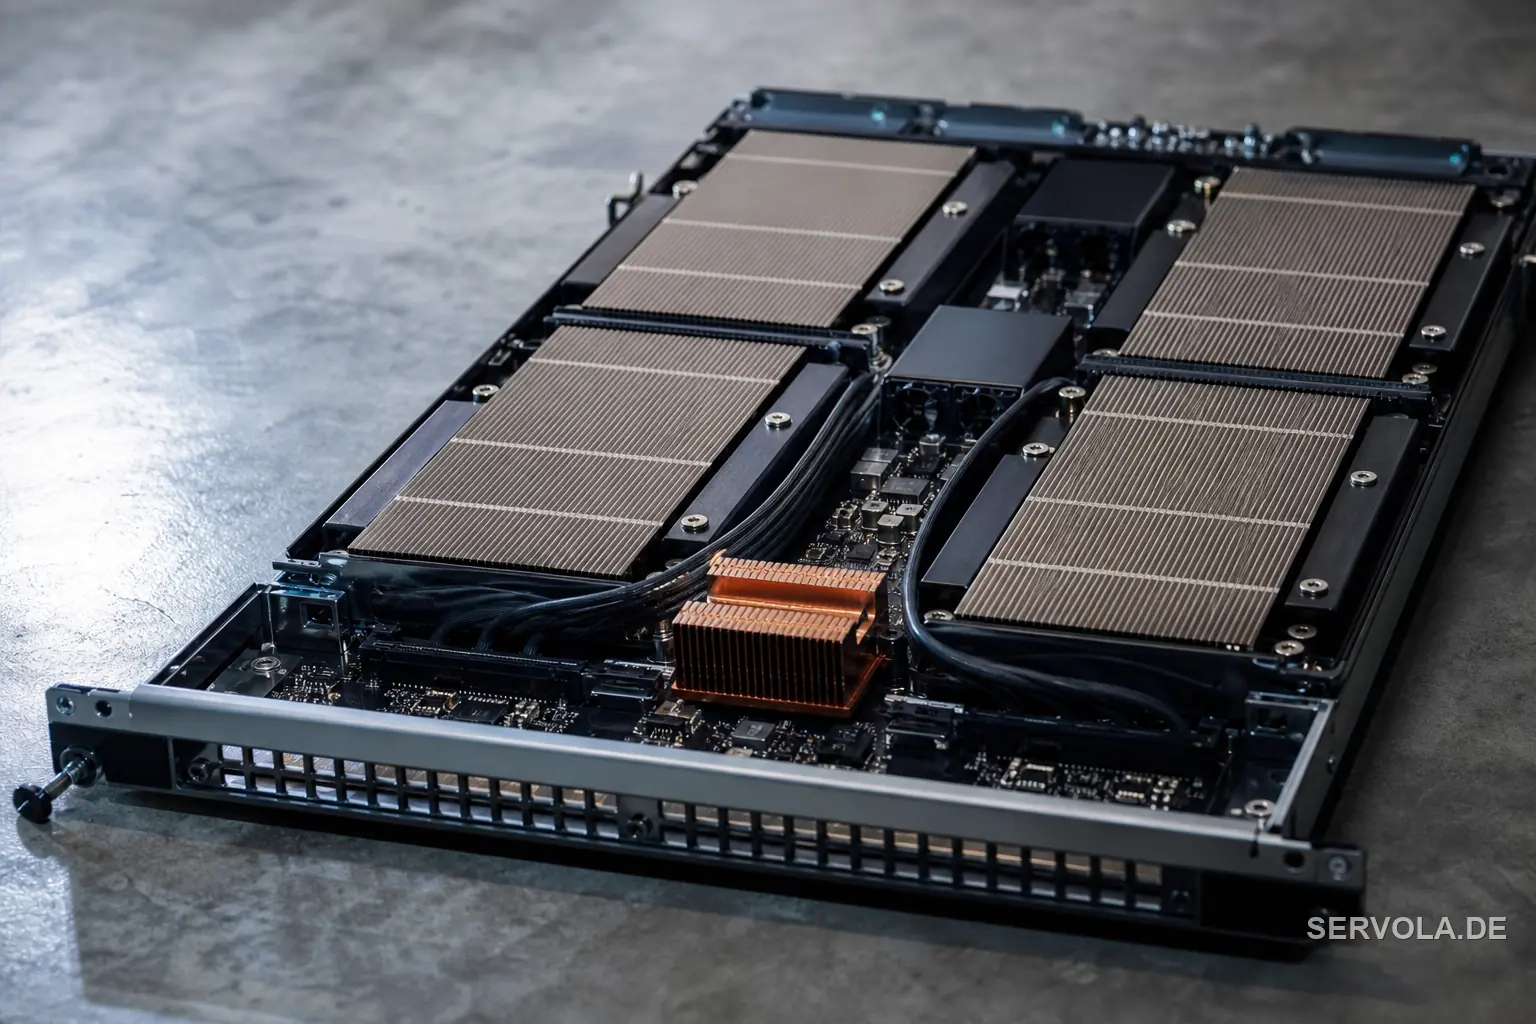
Bloomberg rapporte que Nvidia aurait dit à Microsoft, Google et Oracle que les serveurs équipés de ses puces Vera Rubin et Grace Blackwell coûteront plus de 15% de plus dès 2027, à cause de la hausse du prix de la mémoire.
Page 3 / 11
Une note réfléchie sur l'infrastructure, la gouvernance et la mesure, presque chaque matin. Sans théorie.