Vad Microsoft har lovat
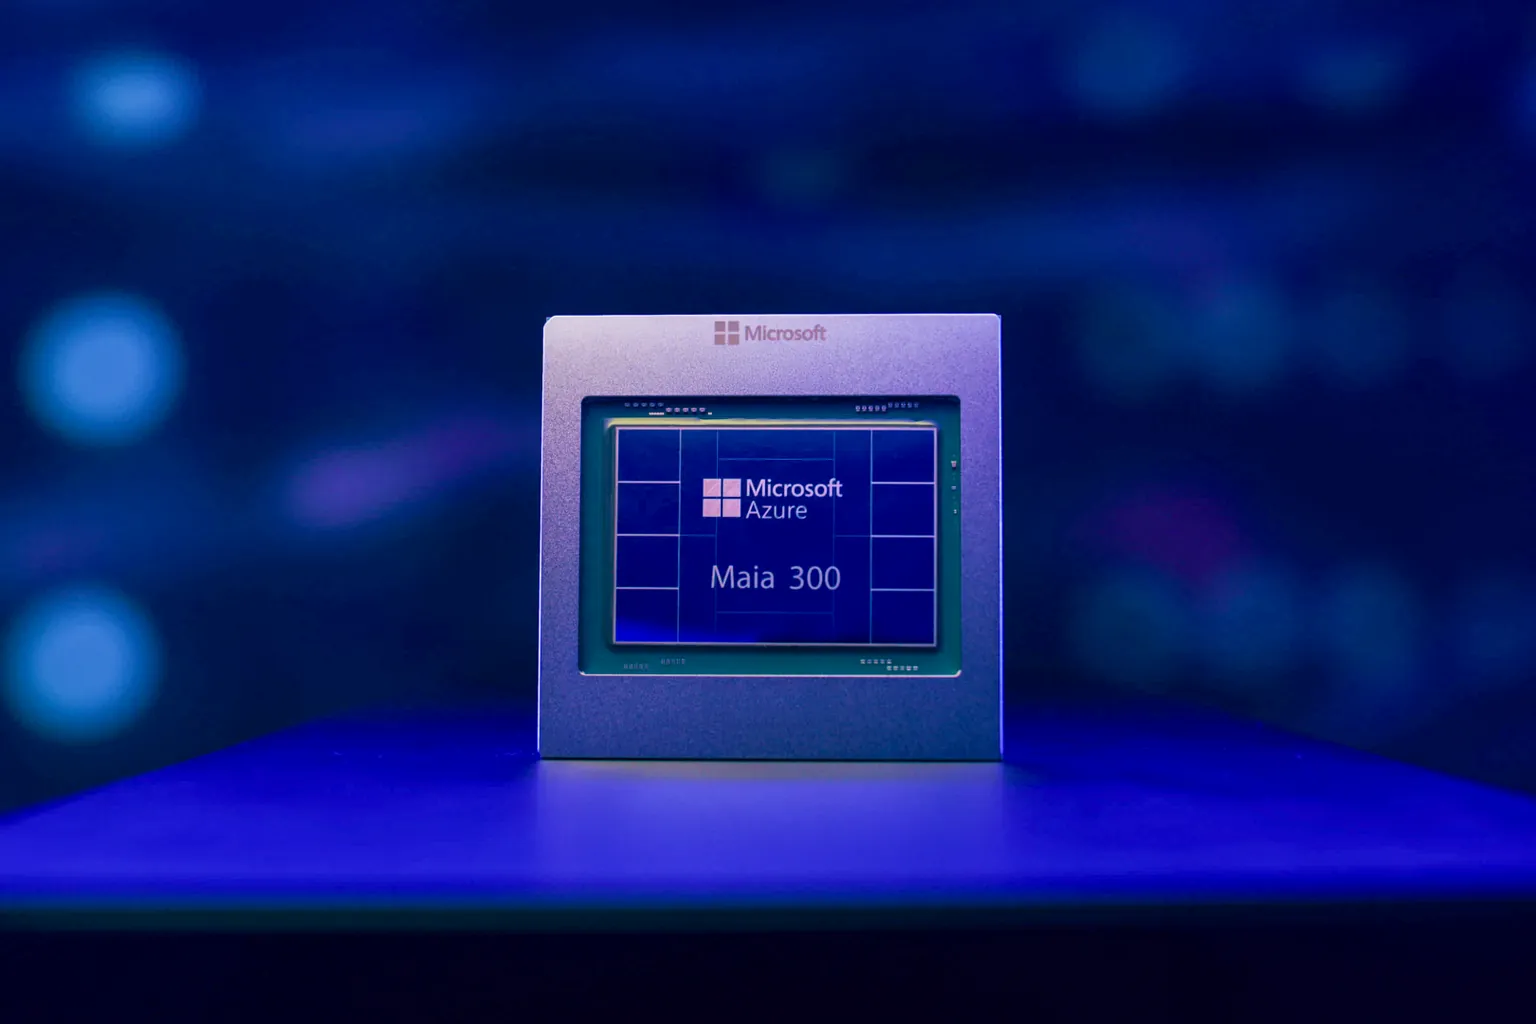
Scott Guthrie, executive vice president för Cloud och AI på Microsoft, sa den 12 oktober att Azure Maia-familjen skalas upp till utrullningar i multigigawattklass från 2027 och blir det primära inferenssystemet för Microsofts produkter och tjänster. Reuters tillägger att Microsoft planerar att rulla ut potentiellt mer än en miljon Maia 300-chip nästa år och räknar med att lägga mer än 175 miljarder dollar på investeringar i år.
Chipet som redan är i drift är Maia 200. Microsoft säger att det hanterar produktionslaster, bland annat Microsoft Copilot, medan GitHub Copilot och Microsoft Foundry följer före årets slut. Det kör OpenAI-modeller, Microsofts egna MAI-modeller och ledande modellfamiljer med öppen källkod och rullas ut i USA, Europa och Australien. För inbyggd AI i Teams, Copilot och Cowork anger Microsoft upp till 1,7 gånger fler tokens per watt än ledande GPU-infrastruktur.
Databladet i en tabell
Det här är siffrorna Microsoft har publicerat för Maia 300, som börjar produktionsutrullas 2027.
| Egenskap | Maia 300 enligt Microsoft |
|---|---|
| Beräkningschiplets | TSMC:s processnod N2P |
| Minne per chip | 8 HBM4-staplar, 18,0 TB/s toppbandbredd |
| Effekt per chip | 950 W TDP |
| Rack | 96 acceleratorer inom en ram på 167 kW |
| Rackminne | 27,6 TB HBM, 1,7 PB/s sammanlagd bandbredd |
| Effektivitetspåstående | 40 procent fler tokens per megawatt än ledande GPU-baserade system |
| Genomströmningspåstående | upp till 7 gånger Maia 200:s tokengenomströmning på racknivå |
Båda effektivitetspåståendena är Microsofts egna förväntningar för ett chip som ännu inte är i serieproduktion. Microsoft nämnde inte vilka GPU-system som jämfördes, noterar Reuters.
Rackets effekt är siffran att fråga efter
Fler tokens per megawatt betyder inte ett lättare rack. Reuters sätter Maia 300-racket till omkring 167 kilowatt för 96 chip, mot 142 kilowatt för Nvidias GB300-rack med 72 GPU:er.
| Rackdesign | Acceleratorer | Rackeffekt |
|---|---|---|
| Microsoft Maia 300 | 96 | omkring 167 kW |
| Nvidia GB300 | 72 GPU:er | 142 kW |
| Nvidia MGX 1.2-designer | ej angivet | upp till 250 kW |
| AMD Helion-referensrack | upp till 16 Instinct MI350P-GPU:er | ingen rackeffekt publicerad |
Nvidia bidrog samma dag med sina Vera Rubin-rackdesigner till Open Compute Project, med vätskekylning på racknivå och en vätskekyld 5 000-ampere strömskena. AMD visade Helion, en öppen rackdesign för agentisk AI, med partnerversioner planerade till november 2026. Den röda tråden är effekt och kylning per rack.
Vem behåller besparingen
Ett chip som levererar fler tokens per megawatt sänker först Microsofts egna driftkostnader. Om något av det når kunderna är ett kommersiellt beslut, och meddelandet säger inget om det.
Maia-kapacitet är Azure-kapacitet, och det är leverantörsinlåsningens sida av saken: ingen av källorna beskriver Maia som tillgängligt utanför Azure. Colocation-kunder som överväger lika täta rack står inför ett annat test, nämligen hur mycket effekt och kylning deras hall kan leverera per rack.
Tre frågor innan ni skriver under
Fråga Microsoft om lägre driftkostnader når priserna per token eller Copilot-licenserna vid er nästa förnyelse, och få svaret i avtalet, inte i en keynote.
Fråga vilka av era arbetslaster som körs på Maia och med vilka modeller, eftersom Microsoft säger att Maia 200 kör OpenAI-modeller, egna MAI-modeller och öppna modellfamiljer. Be varje colocation-leverantör om maximala kilowatt per rack och kyltyp innan ni planerar tät AI-hårdvara.
Läs vidare: Europas kvanthardvara körs nu via Nvidias kompilator | Microsofts AI-nota sjönk bara på pappret