Hvad Microsoft har lovet
Scott Guthrie, executive vice president for Cloud og AI hos Microsoft, sagde den 12. oktober, at Azure Maia-familien skaleres til udrulninger i multigigawatt-størrelse fra 2027 og bliver det primære inferenssystem for Microsofts produkter og tjenester. Reuters tilføjer, at Microsoft planlægger at udrulle potentielt mere end en million Maia 300-chips næste år og forventer at bruge mere end 175 milliarder dollar i investeringer i dette kalenderår.
Den chip, der allerede er i drift, er Maia 200. Microsoft siger, at den betjener produktionsopgaver, herunder Microsoft Copilot, mens GitHub Copilot og Microsoft Foundry følger inden årets udgang. Den kører OpenAI-modeller, Microsofts egne MAI-modeller og førende open source-modelfamilier og udrulles i USA, Europa og Australien. For indbygget AI i Teams, Copilot og Cowork angiver Microsoft op til 1,7 gange flere tokens pr. watt end førende GPU-infrastruktur.
Databladet i én tabel
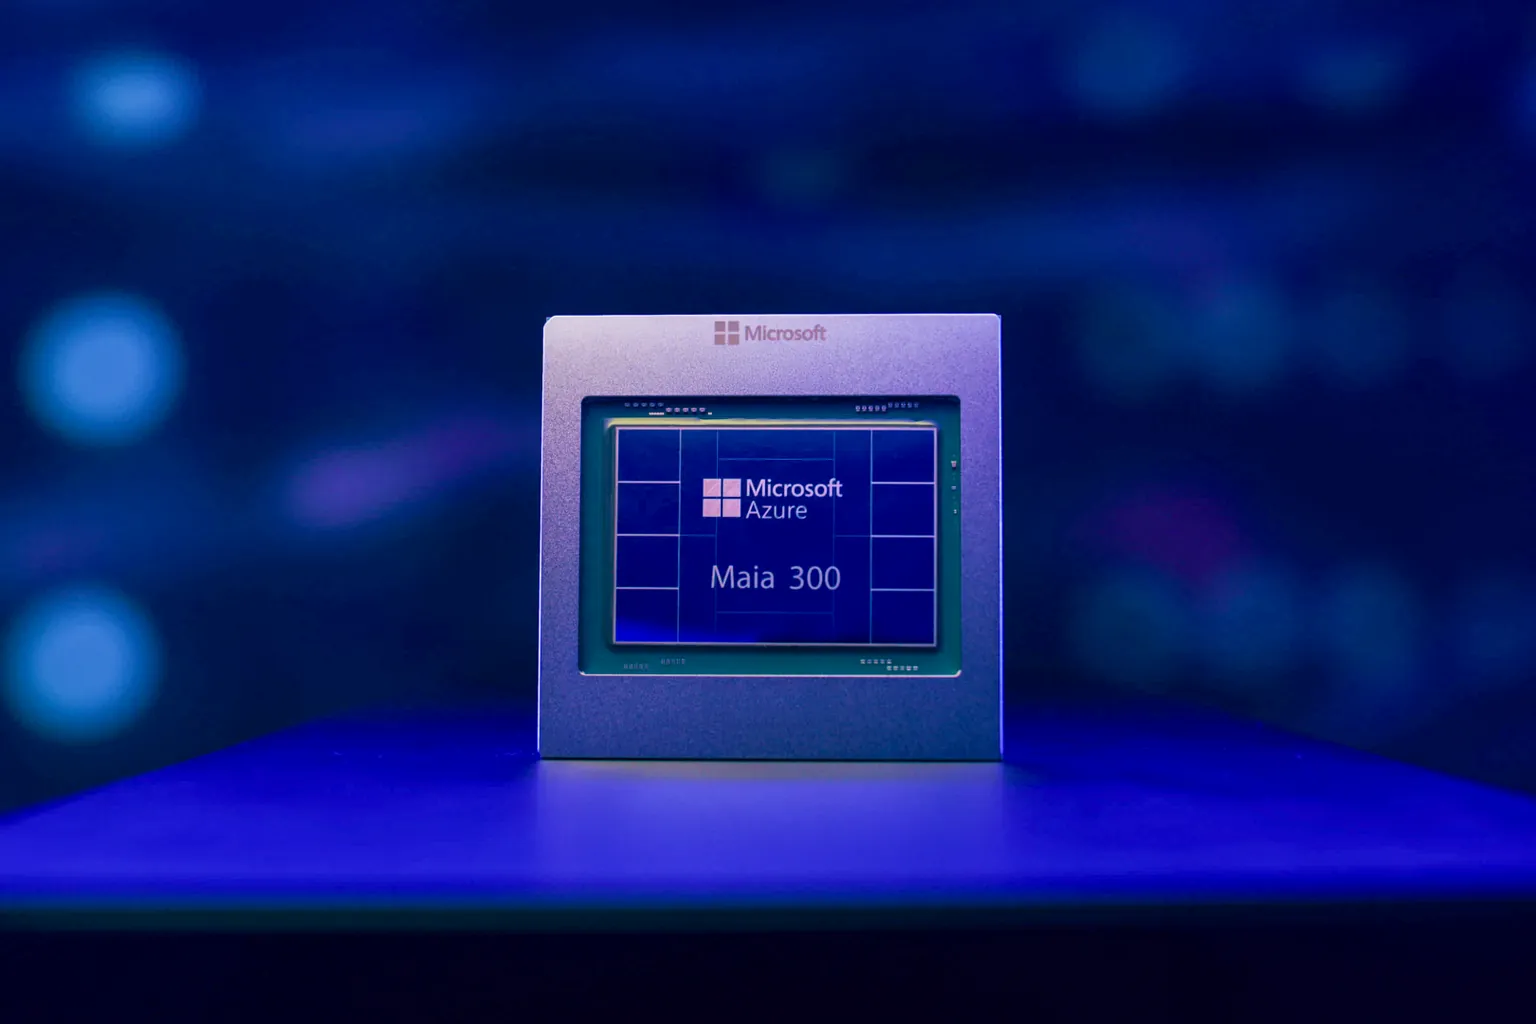
Det er de tal, Microsoft har offentliggjort for Maia 300, som begynder produktionsudrulning i 2027.
| Egenskab | Maia 300 ifølge Microsoft |
|---|---|
| Beregningschiplets | TSMC's N2P-procesnode |
| Hukommelse pr. chip | 8 HBM4-stakke, 18,0 TB/s spidsbåndbredde |
| Effekt pr. chip | 950 W TDP |
| Rack | 96 acceleratorer inden for en ramme på 167 kW |
| Rackhukommelse | 27,6 TB HBM, 1,7 PB/s samlet båndbredde |
| Effektivitetspåstand | 40 procent flere tokens pr. megawatt end førende GPU-baserede systemer |
| Gennemløbspåstand | op til 7 gange Maia 200's tokengennemløb på rackniveau |
Begge effektivitetspåstande er Microsofts egne forventninger til en chip, der endnu ikke er i serieproduktion. Microsoft nævnte ikke de GPU-systemer, der blev sammenlignet med, bemærker Reuters.
Rackets effekt er tallet at spørge til
Flere tokens pr. megawatt betyder ikke et lettere rack. Reuters sætter Maia 300-racket til omkring 167 kilowatt for 96 chips mod 142 kilowatt for Nvidias GB300-rack med 72 GPU'er.
| Rackdesign | Acceleratorer | Rackeffekt |
|---|---|---|
| Microsoft Maia 300 | 96 | omkring 167 kW |
| Nvidia GB300 | 72 GPU'er | 142 kW |
| Nvidia MGX 1.2-designs | ikke oplyst | op til 250 kW |
| AMD Helion-referencerack | op til 16 Instinct MI350P-GPU'er | ingen rackeffekt offentliggjort |
Nvidia bidrog samme dag med sine Vera Rubin-rackdesigns til Open Compute Project, med væskekøling på rackniveau og en væskekølet 5.000-ampere strømskinne. AMD viste Helion, et åbent rackdesign til agentisk AI, med partnerversioner planlagt til november 2026. Den røde tråd er effekt og køling pr. rack.
Hvem beholder besparelsen
En chip, der leverer flere tokens pr. megawatt, sænker først Microsofts egne driftsomkostninger. Om noget af det når kunderne, er en kommerciel beslutning, og meddelelsen siger intet om det.
Maia-kapacitet er Azure-kapacitet, og det er leverandørbindingens side af sagen: ingen af kilderne beskriver Maia som tilgængelig uden for Azure. Colocation-kunder, der overvejer lige så tætte racks, står over for en anden prøve, nemlig hvor meget strøm og køling deres hal kan levere pr. rack.
Tre spørgsmål, før I skriver under
Spørg Microsoft, om de lavere driftsomkostninger kommer til udtryk i priser pr. token eller i Copilot-licenser ved jeres næste fornyelse, og få svaret ind i kontrakten, ikke i en keynote.
Spørg, hvilke af jeres arbejdsbyrder der kører på Maia og med hvilke modeller, for ifølge Microsoft kører Maia 200 OpenAI-modeller, egne MAI-modeller og open source-familier. Bed hver colocation-udbyder om de maksimale kilowatt pr. rack og kølingstypen, før I planlægger tæt AI-hardware.
Læs videre: Europas kvantehardware kører nu via Nvidias kompilator | Microsofts AI-regning faldt kun på papiret