Che cosa ha promesso Microsoft
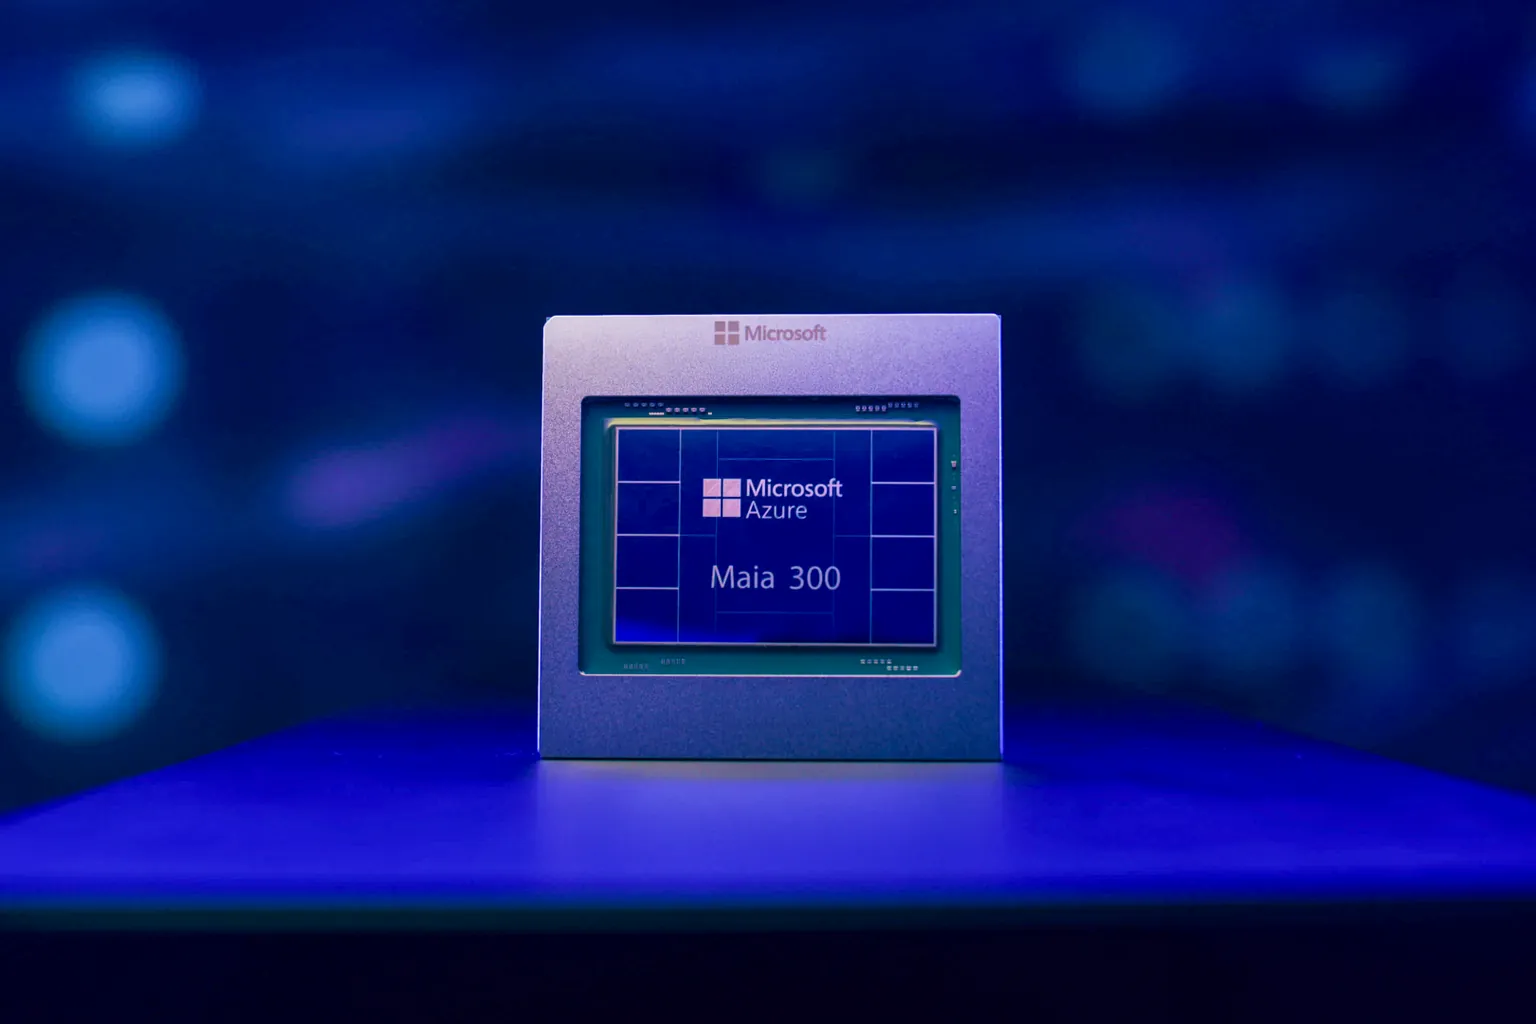
Scott Guthrie, vicepresidente esecutivo di Cloud e IA di Microsoft, ha detto il 12 ottobre che la famiglia Azure Maia crescerà fino a installazioni da più gigawatt a partire dal 2027 e diventerà il sistema principale di inferenza per i prodotti e i servizi di Microsoft. Reuters aggiunge che Microsoft prevede di installare potenzialmente più di un milione di chip Maia 300 il prossimo anno e che si aspetta investimenti per oltre 175 miliardi di dollari in questo anno solare.
Il chip già in servizio è Maia 200. Microsoft dice che serve già carichi di produzione, incluso Microsoft Copilot, e che GitHub Copilot e Microsoft Foundry seguiranno entro fine anno. Esegue modelli OpenAI, i modelli MAI di Microsoft e le principali famiglie open source, ed è in distribuzione in Stati Uniti, Europa e Australia. Per l'IA integrata in Teams, Copilot e Cowork, Microsoft dichiara fino a 1,7 volte più token per watt rispetto alla principale infrastruttura GPU.
La scheda tecnica in una tabella
Sono i dati che Microsoft ha pubblicato per Maia 300, che avvia le installazioni di produzione nel 2027.
| Voce | Maia 300 secondo Microsoft |
|---|---|
| Chiplet di calcolo | nodo N2P di TSMC |
| Memoria per chip | 8 stack HBM4, 18,0 TB/s di banda di picco |
| Potenza per chip | 950 W di TDP |
| Rack | 96 acceleratori in un limite di 167 kW |
| Memoria del rack | 27,6 TB di HBM, 1,7 PB/s di banda aggregata |
| Dichiarazione di efficienza | 40 per cento di token in più per megawatt rispetto ai principali sistemi basati su GPU |
| Dichiarazione di throughput | fino a 7 volte il throughput di token a livello di rack di Maia 200 |
Entrambe le dichiarazioni di efficienza sono previsioni di Microsoft per un chip non ancora in produzione di serie. Microsoft non ha indicato i sistemi GPU usati per il confronto, nota Reuters.
La potenza del rack è il numero su cui fare domande
Più token per megawatt non significano un rack più leggero. Reuters colloca il rack Maia 300 a circa 167 kilowatt per 96 chip, contro i 142 kilowatt del rack GB300 di Nvidia con 72 GPU.
| Progetto di rack | Acceleratori | Potenza del rack |
|---|---|---|
| Microsoft Maia 300 | 96 | circa 167 kW |
| Nvidia GB300 | 72 GPU | 142 kW |
| Progetti Nvidia MGX 1.2 | non indicato | fino a 250 kW |
| Rack di riferimento AMD Helion | fino a 16 GPU Instinct MI350P | nessuna potenza pubblicata |
Nvidia ha messo a disposizione lo stesso giorno i suoi progetti di rack Vera Rubin all'Open Compute Project, con raffreddamento a liquido a livello di rack e una barra di distribuzione da 5.000 ampere raffreddata a liquido. AMD ha presentato Helion, un progetto di rack aperto per l'IA agentica, con versioni dei partner previste a novembre 2026. Il filo comune sono la potenza e il raffreddamento per rack.
Chi si tiene il risparmio
Un chip che serve più token per megawatt abbassa prima di tutto il costo di servizio della stessa Microsoft. Se qualcosa arrivi ai clienti è una decisione commerciale, e l'annuncio non dice nulla in proposito.
La capacità Maia è capacità Azure, ed è il lato del vincolo al fornitore: nessuna delle fonti descrive Maia come disponibile fuori da Azure. I clienti in colocation che valutano rack altrettanto densi affrontano un test diverso, cioè quanta potenza e quanto raffreddamento la loro sala può dare per rack.
Tre domande prima di firmare
Chiedete a Microsoft se il minor costo di servizio arriverà ai prezzi per token o alle licenze Copilot al vostro prossimo rinnovo, e fatevi dare la risposta nel contratto, non in una keynote.
Chiedete quali dei vostri carichi girano su Maia e con quali modelli, perché Microsoft dice che Maia 200 esegue modelli OpenAI, i propri modelli MAI e famiglie open source. Chiedete a ogni fornitore di colocation i kilowatt massimi per rack e il tipo di raffreddamento prima di pianificare hardware IA denso.
Da leggere ora: L'hardware quantistico europeo passa dal compilatore di Nvidia | La bolletta IA di Microsoft è scesa solo sulla carta