O que a Microsoft prometeu
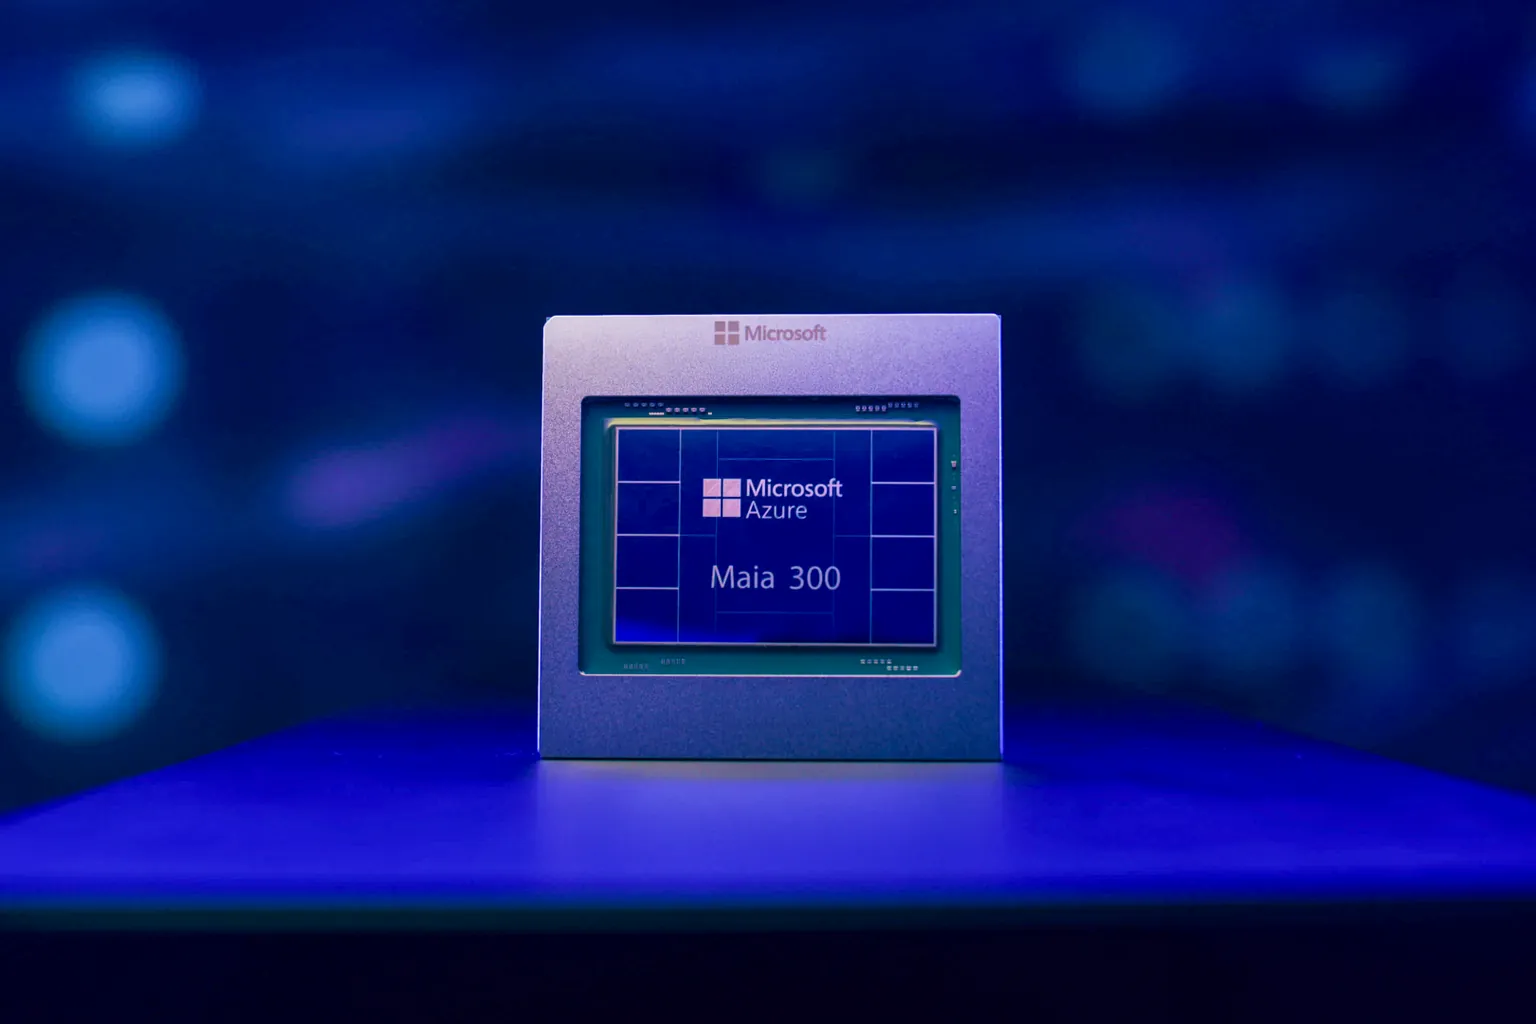
Scott Guthrie, vice-presidente executivo de Cloud e IA da Microsoft, afirmou a 12 de outubro que a família Azure Maia vai escalar para implementações de vários gigawatts a partir de 2027 e tornar-se o principal sistema de inferência dos produtos e serviços da Microsoft. A Reuters acrescenta que a Microsoft planeia implementar potencialmente mais de um milhão de chips Maia 300 no próximo ano e espera gastar mais de 175 mil milhões de dólares em investimento este ano civil.
O chip já em serviço é o Maia 200. A Microsoft diz que serve cargas de produção, incluindo o Microsoft Copilot, e que o GitHub Copilot e o Microsoft Foundry se seguirão até ao fim do ano. Executa modelos da OpenAI, os modelos MAI da Microsoft e as principais famílias de código aberto, e está a ser implementado nos Estados Unidos, na Europa e na Austrália. Para a IA integrada no Teams, no Copilot e no Cowork, a Microsoft indica até 1,7 vezes mais tokens por watt do que a infraestrutura GPU de topo.
A ficha técnica numa tabela
Estes são os valores que a Microsoft publicou para o Maia 300, que inicia a implementação em produção em 2027.
| Característica | Maia 300 segundo a Microsoft |
|---|---|
| Chiplets de cálculo | nó N2P da TSMC |
| Memória por chip | 8 pilhas HBM4, 18,0 TB/s de largura de banda máxima |
| Potência por chip | 950 W de TDP |
| Rack | 96 aceleradores num envelope de 167 kW |
| Memória do rack | 27,6 TB de HBM, 1,7 PB/s de largura de banda agregada |
| Afirmação de eficiência | mais 40 por cento de tokens por megawatt do que os sistemas baseados em GPU de topo |
| Afirmação de débito | até 7 vezes o débito de tokens à escala do rack do Maia 200 |
As duas afirmações de eficiência são previsões da própria Microsoft para um chip que ainda não está em produção em série. A Microsoft não nomeou os sistemas GPU usados na comparação, nota a Reuters.
A potência do rack é o número a perguntar
Mais tokens por megawatt não significam um rack mais leve. A Reuters situa o rack Maia 300 em cerca de 167 quilowatts para 96 chips, contra 142 quilowatts do rack GB300 da Nvidia com 72 GPU.
| Desenho de rack | Aceleradores | Potência do rack |
|---|---|---|
| Microsoft Maia 300 | 96 | cerca de 167 kW |
| Nvidia GB300 | 72 GPU | 142 kW |
| Desenhos Nvidia MGX 1.2 | não indicado | até 250 kW |
| Rack de referência AMD Helion | até 16 GPU Instinct MI350P | sem potência publicada |
A Nvidia contribuiu no mesmo dia com os seus desenhos de rack Vera Rubin para o Open Compute Project, com arrefecimento líquido ao nível do rack e uma barra de distribuição de 5000 ampères arrefecida a líquido. A AMD mostrou o Helion, um desenho de rack aberto para IA agêntica, com versões de parceiros previstas para novembro de 2026. O denominador comum é a potência e o arrefecimento por rack.
Quem fica com a poupança
Um chip que serve mais tokens por megawatt reduz primeiro o custo de serviço da própria Microsoft. Se alguma parte chega aos clientes é uma decisão comercial, e o anúncio não diz nada sobre isso.
A capacidade Maia é capacidade Azure, e esse é o lado da dependência do fornecedor: nenhuma das fontes descreve o Maia como disponível fora do Azure. Os clientes de colocation que ponderem racks igualmente densos enfrentam outro teste, o de quanta potência e arrefecimento a sua sala consegue dar por rack.
Três perguntas antes de assinar
Pergunte à Microsoft se o menor custo de serviço chegará aos preços por token ou às licenças do Copilot na sua próxima renovação, e obtenha a resposta no contrato, não numa keynote.
Pergunte quais das suas cargas correm no Maia e com que modelos, porque a Microsoft diz que o Maia 200 executa modelos da OpenAI, os seus próprios modelos MAI e famílias de código aberto. Peça a cada fornecedor de colocation os quilowatts máximos por rack e o tipo de arrefecimento antes de planear hardware de IA denso.
Leia a seguir: O hardware quântico europeu passa agora pelo compilador da Nvidia | A fatura de IA da Microsoft caiu só no papel