Lo que Microsoft ha prometido
Scott Guthrie, vicepresidente ejecutivo de Cloud e IA de Microsoft, dijo el 12 de octubre que la familia Azure Maia escalará a despliegues de varios gigavatios a partir de 2027 y se convertirá en el sistema principal de inferencia de los productos y servicios de Microsoft. Reuters añade que Microsoft planea desplegar potencialmente más de un millón de chips Maia 300 el año próximo y que espera gastar más de 175.000 millones de dólares en inversiones este año natural.
El chip que ya funciona es Maia 200. Microsoft dice que ya atiende cargas de producción, incluido Microsoft Copilot, y que GitHub Copilot y Microsoft Foundry seguirán antes de fin de año. Ejecuta modelos de OpenAI, los modelos MAI de Microsoft y familias líderes de código abierto, y se despliega en Estados Unidos, Europa y Australia. Para la IA integrada en Teams, Copilot y Cowork, Microsoft declara hasta 1,7 veces más tokens por vatio que la infraestructura GPU líder.
La ficha técnica en una tabla
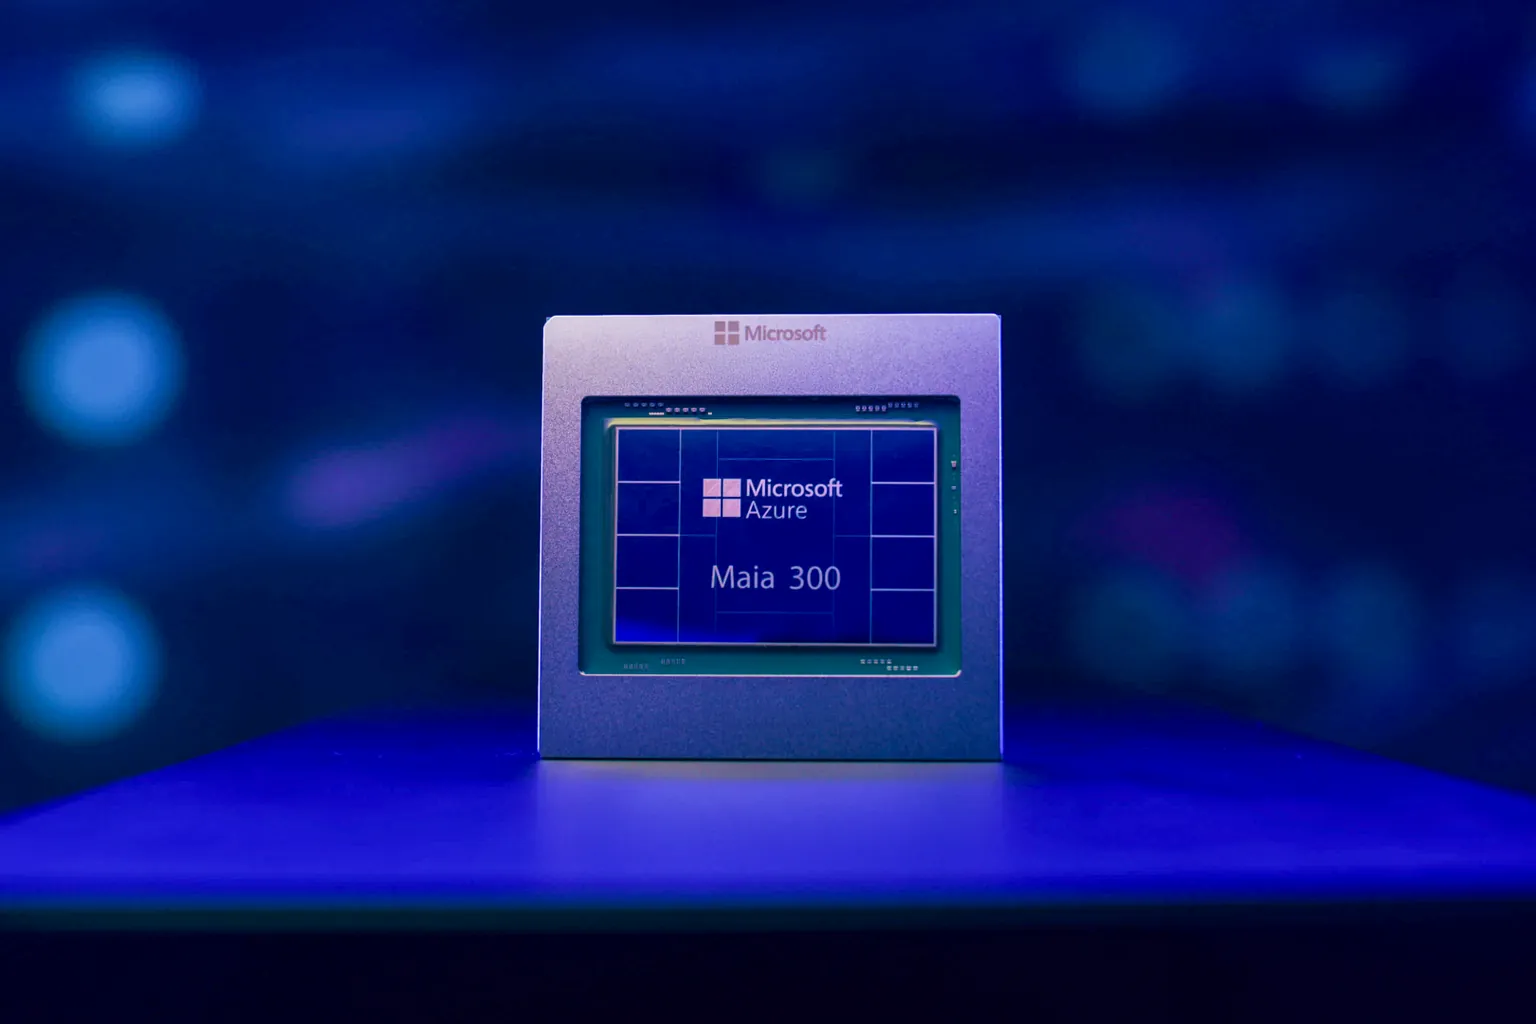
Estas son las cifras que Microsoft publicó de Maia 300, que inicia despliegues de producción en 2027.
| Característica | Maia 300 según Microsoft |
|---|---|
| Chiplets de cómputo | nodo N2P de TSMC |
| Memoria por chip | 8 pilas HBM4, 18,0 TB/s de ancho de banda máximo |
| Potencia por chip | 950 W de TDP |
| Rack | 96 aceleradores en un margen de 167 kW |
| Memoria del rack | 27,6 TB de HBM, 1,7 PB/s de ancho de banda agregado |
| Afirmación de eficiencia | 40 por ciento más de tokens por megavatio que los sistemas basados en GPU líderes |
| Afirmación de rendimiento | hasta 7 veces el rendimiento de tokens a escala de rack de Maia 200 |
Las dos afirmaciones de eficiencia son previsiones de Microsoft para un chip que aún no se fabrica en serie. Microsoft no nombró los sistemas GPU con los que se comparó, señala Reuters.
La potencia del rack es la cifra por la que preguntar
Más tokens por megavatio no significan un rack más ligero. Reuters sitúa el rack Maia 300 en unos 167 kilovatios para 96 chips, frente a 142 kilovatios del rack GB300 de Nvidia con 72 GPU.
| Diseño de rack | Aceleradores | Potencia del rack |
|---|---|---|
| Microsoft Maia 300 | 96 | unos 167 kW |
| Nvidia GB300 | 72 GPU | 142 kW |
| Diseños Nvidia MGX 1.2 | no indicado | hasta 250 kW |
| Rack de referencia AMD Helion | hasta 16 GPU Instinct MI350P | sin cifra de potencia publicada |
Nvidia aportó el mismo día sus diseños de rack Vera Rubin al Open Compute Project, con refrigeración líquida a nivel de rack y una barra de distribución de 5.000 amperios refrigerada por líquido. AMD presentó Helion, un diseño de rack abierto para IA agéntica, con versiones de socios previstas para noviembre de 2026. El denominador común es la potencia y la refrigeración por rack.
Quién se queda con el ahorro
Un chip que sirve más tokens por megavatio reduce primero el coste de servicio de la propia Microsoft. Que algo de ello llegue al cliente es una decisión comercial, y el anuncio no dice nada al respecto.
La capacidad Maia es capacidad Azure, y ese es el lado de la dependencia del proveedor: ninguna de las fuentes describe Maia como disponible fuera de Azure. Los clientes de colocation que consideren racks igual de densos se enfrentan a otra prueba, la de cuánta potencia y refrigeración puede dar su sala por rack.
Tres preguntas antes de firmar
Pregunte a Microsoft si el menor coste de servicio llegará a los precios por token o a las licencias de Copilot en su próxima renovación, y consiga la respuesta en el contrato, no en una keynote.
Pregunte cuáles de sus cargas funcionan en Maia y con qué modelos, ya que Microsoft dice que Maia 200 ejecuta modelos de OpenAI, sus propios modelos MAI y familias de código abierto. Pida a cualquier proveedor de colocation los kilovatios máximos por rack y el tipo de refrigeración antes de planificar hardware de IA denso.
Leer a continuación: El hardware cuántico europeo ya pasa por el compilador de Nvidia | La factura de IA de Microsoft bajó solo en el papel